> ## Documentation Index
> Fetch the complete documentation index at: https://datagen.dev/llms.txt
> Use this file to discover all available pages before exploring further.
# 資料總覽
> 連接資料庫與檔案、用 SQL 建立分析資料,並發布 Agent 與 App 可讀取的快照
**資料(Data)** 把資料庫、物件儲存與工作區檔案中的資料表,轉成可重複使用的
**分析資料**(Data Model)。來源只需連接一次,再自己撰寫(或請 AI
資料建構器撰寫)整理資料的 SQL,然後發布結果。Agent 與 App 讀取的是發布後的分析資料,
從不直接接觸原始連線,因此憑證留在 DataGen 內,所有使用者看到的都是同一份有說明文件的數字。
從導覽列的 **更多** 選單開啟 **資料**(可以釘選到導覽列上)。頁面有三個分頁:
**資料集**、**連線** 與 **設定**。
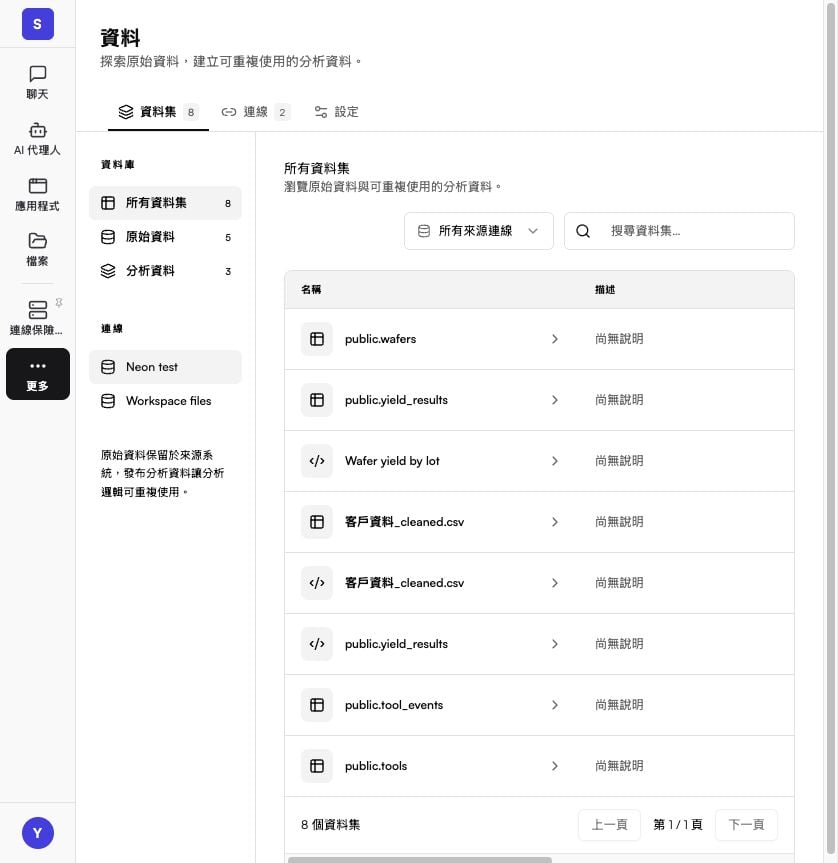 ## 生命週期
```text theme={null}
連線 ──> 原始資料 ──> 分析資料 ──> 發布 ──> 版本 + 快照 ──> Agent / App
^ |
└── 更新 ─────┘
```
管理員為 PostgreSQL、MySQL / MariaDB、Oracle 或 S3 上的 Parquet 檔案儲存一個唯讀
**連線**。DataGen 會先確認能連上資料庫才儲存。請參閱[連接資料來源](/zh/data/connect)。
用 **管理資料表** 選擇要開放的資料表。每個選取的資料表都會成為一個 **原始資料**,
並擁有固定的 SQL 名稱。**檔案** 中的 CSV、TSV 或 Parquet 檔案也可以成為原始資料;
在 Oracle 上,已儲存的查詢也可以。
**分析資料** 是建立在原始資料與其他分析資料之上的 SQL 查詢。可以自己撰寫,也可以向
**資料建構器** Agent 描述需求,再預覽結果並為欄位撰寫說明。請參閱[建立分析資料](/zh/data/build-models)。
**發布資料集** 會把 SQL 凍結成新的 **版本**。實體化的分析資料會在發布時建置成
Parquet **快照**。
更新會手動或依排程重新執行已發布的 SQL,並存成新的快照。每個發布過的版本都保留在
歷史紀錄中,可以回溯到其中任何一個。
把發布後的分析資料連結到 Agent。Agent 會在沙盒中用 `datagen-data` CLI 查詢它的快照。
請參閱[在 Agent 與 App 中使用資料](/zh/data/use)。
## 核心概念
| 概念 | 說明 |
| - | - |
| **連線** | 一個資料庫或 S3 儲存貯體的主機、資料庫與憑證。憑證經過加密,不會傳到瀏覽器,也不會進入沙盒。 |
| **原始資料** | 從連線登錄的資料表(或檔案、Oracle 查詢)。原始資料是即時讀取的:查詢會讀到當下的資料列。 |
| **分析資料** | 建立在原始資料與其他分析資料之上的 SQL 定義,含名稱、說明、欄位說明與說明文件(`model.md`)。 |
| **模式** | **分析 SQL** 以 DuckDB SQL 跨任意原始資料執行;**原生 SQL** 在單一連線上原樣執行該資料庫自己的 SQL。 |
| **執行模式** | **即時查詢** 在每次讀取分析資料時執行 SQL;**實體化** 把結果存成快照。Agent 只能讀取實體化的分析資料。 |
| **版本** | 每次發布產生一份不可變更的分析資料定義。標示 **上線中** 的版本就是使用者讀取的版本。 |
| **快照** | 建置實體化版本得到的 Parquet 結果。更新會為同一版本產生新的快照。 |
## SQL 名稱
每個資料集都有一個 SQL 名稱,重新命名資料集也不會改變。在資料集的動作選單中用
**複製 SQL 查詢名稱** 複製它。
| 資料集 | SQL 名稱 |
| - | - |
| 資料庫資料表 | `data.<連線別名>..<資料表>` |
| Oracle 查詢原始資料 | `data.<連線別名>.query.<名稱>` |
| 工作區檔案 | `data.files.raw.<檔名>` 或 `data.files.outputs.<檔名>` |
| 分析資料、Parquet 原始資料 | `data.`,例如 `data.dataset_3f2a...` |
## 角色權限
| 操作 | 角色 |
| - | - |
| 新增、編輯、刪除連線;管理資料表;新增檔案與查詢原始資料;變更資料建構器設定 | 管理員 |
| 建立、編輯、發布與回溯分析資料;編輯說明;設定更新排程 | 管理員、建構者 |
| 預覽原始資料與已發布的分析資料;更新已發布資料 | 管理員、建構者、操作員 |
| 瀏覽資料集與已發布的分析資料 | 所有成員 |
尚未發布的草稿只有管理員與建構者看得到。
## 限制
| 項目 | 上限 |
| - | - |
| 單一實體化分析資料快照的資料列數 | 100,000 |
| 每個工作區的快照儲存空間 | 512 MiB |
| 原始資料或查詢結果預覽的資料列數 | 500(每頁 50) |
| SQL 編輯器的查詢時間 | 30 秒 |
| 作為原始資料讀取的工作區檔案 | 預設 512 MiB |
| 單次儲存可新增的資料表數 | 100 |
資料是受管控的途徑:憑證由管理員保管,Agent 只讀取發布後的快照。如果 Agent 需要對即時
資料庫自行執行查詢,請改用連線保險庫提供唯讀憑證。請參閱[從程式碼查詢資料庫](/zh/data/query-from-code)。
## 下一步
新增 PostgreSQL、MySQL、Oracle 或 Parquet 連線並選擇資料表。
撰寫或產生分析資料 SQL、預覽、發布並保持資料最新。
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.